

Bloquer les robots qui aspirent un site pour entraîner une intelligence artificielle, tout en laissant Google l’indexer, semble être un arbitrage assez simple.
À partir du 15 septembre 2026, il va falloir regarder les réglages d’un peu plus près.
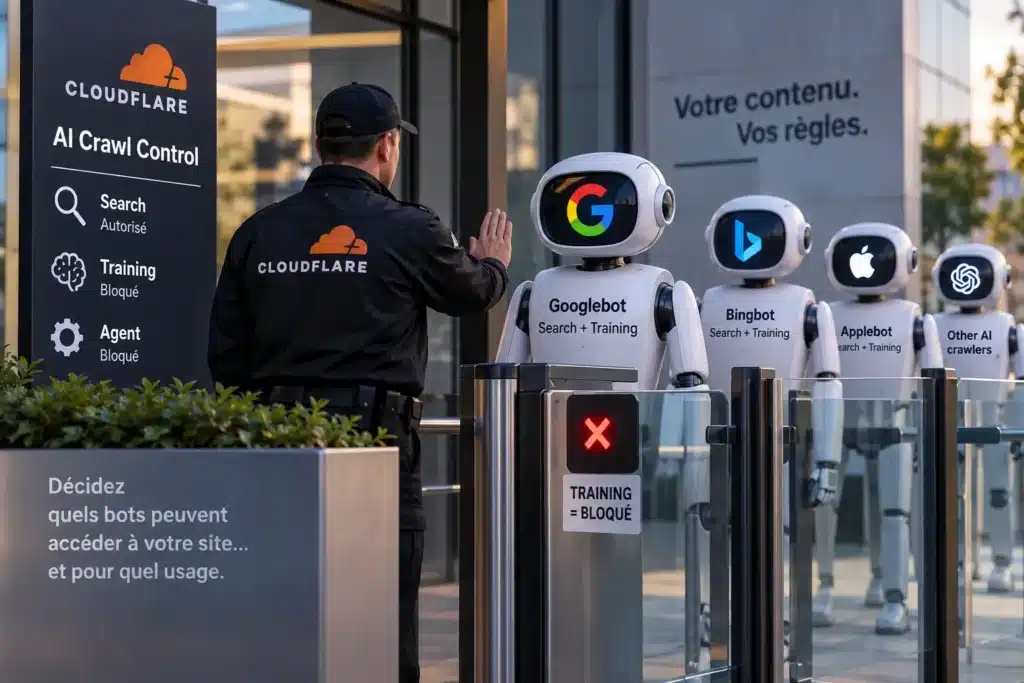
Cloudflare fait évoluer son système de contrôle des robots IA et distingue désormais trois usages : Search, Training et Agent. Jusqu’ici, rien de particulièrement inquiétant. Un éditeur peut vouloir être visible dans les moteurs de recherche tout en refusant que ses contenus servent à entraîner des modèles.
Le problème apparaît lorsqu’un même crawler remplit plusieurs fonctions.
Cloudflare classe notamment Googlebot, Bingbot et Applebot comme des crawlers à usages multiples. À compter du 15 septembre, un site qui demande à Cloudflare de bloquer les crawlers utilisés pour le Training pourra donc également bloquer ces robots, même s’ils servent par ailleurs à la recherche.
Autrement dit : en voulant fermer la porte à l’entraînement des IA, il devient possible de fermer aussi celle par laquelle Google venait indexer le site.
Le genre de détail qu’il vaut mieux découvrir dans un article que dans Search Console trois semaines plus tard.
Dans cet article :
- Ce qui change chez Cloudflare le 15 septembre
- Search, Training et Agent : trois robots en un
- Pourquoi Googlebot se retrouve dans l’histoire
- Bloquer Googlebot signifie-t-il disparaître de Google ?
- robots.txt et Cloudflare ne font pas exactement la même chose
- SEO et GEO commencent à partager le même videur
- Que vérifier dans Cloudflare ?
- Faut-il autoriser ou bloquer les bots IA ?
- Que retenir de cet article ?
Ce qui change chez Cloudflare le 15 septembre
Cloudflare avait déjà lancé en juillet 2025 une fonction permettant de bloquer les robots utilisés pour entraîner des modèles d’IA.
Le système devient désormais beaucoup plus granulaire.
Depuis juillet 2026, Cloudflare permet de gérer les crawlers selon trois comportements différents.
Search correspond aux robots qui collectent et indexent du contenu afin de pouvoir le restituer ultérieurement dans un moteur ou un système de réponse.
Training concerne les robots utilisant le contenu pour entraîner ou affiner des modèles.
Agent correspond aux accès réalisés en temps réel pour le compte d’un utilisateur, par exemple lorsqu’un assistant IA consulte une page afin de répondre à une demande.
Chaque catégorie peut être autorisée ou bloquée selon la politique choisie par le propriétaire du site.
Le 15 septembre 2026, de nouveaux réglages par défaut entrent en vigueur pour les nouveaux domaines utilisant Cloudflare : les usages Training et Agent seront bloqués par défaut sur les pages affichant de la publicité, tandis que Search restera autorisé.
Sur le papier, la séparation semble parfaite.
Le moteur de recherche entre.
Le robot d’entraînement reste dehors.
L’agent qui voudrait consommer le contenu sans envoyer un humain sur la page peut également être arrêté.
Sauf que les robots eux-mêmes ne respectent pas toujours cette jolie séparation.
Search, Training et Agent : trois usages différents
Un crawler n’a pas nécessairement une seule fonction.
C’est précisément le problème auquel Cloudflare veut maintenant répondre.
Certains opérateurs utilisent un même robot pour plusieurs finalités : indexer des pages pour un moteur de recherche, alimenter certaines fonctions d’IA ou récupérer du contenu destiné à d’autres services.
Cloudflare parle de mixed-purpose crawlers, des crawlers à usages multiples.
Et à partir du 15 septembre, le service indique qu’il appliquera à ces robots la règle la plus restrictive correspondant à leurs différents usages.
Prenons un cas simplifié.
Search : autorisé
Training : bloqué
On pourrait naturellement penser que tout robot de recherche continuera à passer.
Mais si un crawler est classé simultanément comme Search et Training, les deux règles s’appliquent.
Et le blocage l’emporte.
C’est ici que le sujet cesse d’être une petite nouveauté dans l’interface Cloudflare.
Pourquoi Googlebot se retrouve dans l’histoire
Cloudflare ne laisse aucune ambiguïté sur les principaux crawlers concernés.
Dans son annonce, l’entreprise cite explicitement Googlebot, Applebot et Bingbot.
Ces robots peuvent remplir plusieurs fonctions et seront donc concernés lorsqu’un client décide de bloquer l’usage Training.
Le cas Google est particulièrement intéressant.
Depuis des années, le réflexe SEO consiste évidemment à laisser passer Googlebot. Google propose parallèlement Google-Extended, un contrôle permettant aux éditeurs d’indiquer que leurs contenus ne doivent pas être utilisés pour certaines fonctions d’IA générative de Google sans empêcher leur présence dans Google Search.
Cloudflare rappelle lui-même cette distinction : un propriétaire peut par exemple refuser Google-Extended dans son fichier robots.txt tout en laissant Googlebot accéder au site pour le référencement naturel.
Mais Cloudflare ajoute désormais une couche supplémentaire.
Le pare-feu ne se contente pas nécessairement de l’intention déclarée dans robots.txt. Il peut décider si la requête du crawler atteint la page selon sa propre classification du robot et les politiques choisies par le propriétaire du site.
Ce qui nous amène à une différence essentielle.
Bloquer Googlebot signifie-t-il disparaître de Google ?
Pas instantanément.
Mais bloquer durablement l’accès de Googlebot à un site est évidemment une très mauvaise stratégie lorsqu’on souhaite être correctement exploré et indexé.
Google doit pouvoir revenir sur les pages pour découvrir les nouveaux contenus, constater leurs modifications, suivre les liens et mettre à jour son index.
Un blocage réseau n’équivaut pas à une directive noindex.
Une page déjà connue de Google ne disparaîtra donc pas nécessairement à la seconde où le crawler reçoit son premier refus.
Mais si Googlebot ne peut plus explorer normalement le site, les conséquences SEO finiront par apparaître.
Pour un média publiant régulièrement, empêcher Googlebot d’accéder aux nouveaux articles serait une manière assez originale d’améliorer son référencement.
Le point important est donc de ne pas traiter l’option « Block AI bots » comme un simple interrupteur sans conséquence SEO potentielle.
Cloudflare précise d’ailleurs que son ancien réglage Block AI bots est déprécié le 15 septembre au profit de politiques plus fines.
robots.txt et Cloudflare ne font pas exactement la même chose
C’est probablement la distinction la plus importante à comprendre.
Un fichier robots.txt communique des instructions aux robots qui choisissent de les respecter.
Cloudflare intervient, lui, avant le serveur Web.
Lorsqu’une politique Cloudflare bloque un crawler, celui-ci peut être arrêté au niveau du réseau avant même d’accéder normalement au contenu.
On peut donc avoir un robots.txt parfaitement raisonnable et une politique Cloudflare beaucoup plus restrictive.
Inversement, autoriser un crawler dans Cloudflare ne signifie pas automatiquement lui donner toutes les permissions dans robots.txt.
Les deux couches sont complémentaires.
Cela donne désormais au propriétaire d’un site plusieurs niveaux de décision :
Qui peut techniquement accéder à mes pages ?
Qui est autorisé à les explorer ?
Pour quel usage ?
Et potentiellement demain :
À quelles conditions économiques ?
Cloudflare travaille d’ailleurs depuis 2025 sur des mécanismes permettant aux éditeurs de mesurer le rapport entre le nombre de pages récupérées par les robots IA et le trafic qu’ils renvoient.
Ses données avaient déjà mis en évidence un déséquilibre spectaculaire entre crawling et visites pour certaines plateformes IA.
SEO et GEO commencent à partager le même videur
Cette évolution est particulièrement intéressante pour le GEO.
Pendant longtemps, le SEO était essentiellement une discipline d’optimisation de contenu, de structure, de liens et de performance technique.
L’arrivée des moteurs génératifs ajoute une question nouvelle :
quels systèmes a-t-on réellement envie de laisser consommer le contenu ?
Il peut être parfaitement rationnel pour un éditeur de vouloir :
- être indexé par Google ;
- être cité dans ChatGPT ;
- autoriser un agent à consulter une fiche produit pour répondre à un utilisateur ;
- mais refuser qu’un crawler aspire plusieurs années d’archives pour entraîner un modèle.
Le problème est que ces usages ne sont pas toujours techniquement séparés.
Cloudflare indique d’ailleurs qu’en juin 2026, les crawlers à usages multiples représentaient plus de 36 % de l’activité des crawlers qu’il observait, tandis que l’entraînement représentait 52 % des requêtes de crawlers IA observées.
Le choix entre visibilité et contrôle du contenu devient donc moins binaire qu’un simple Allow / Disallow.
Et c’est probablement un avant-goût d’un sujet auquel les responsables SEO vont devoir s’habituer.
Le référencement ne consiste plus seulement à expliquer aux robots ce qu’ils doivent indexer.
Il commence aussi à falloir décider quel robot peut lire quoi, pour faire quoi.
Que vérifier dans Cloudflare ?
Pour un site utilisant Cloudflare, la première chose à faire est assez simple : ne pas attendre une baisse de crawl pour découvrir sa configuration.
Dans l’interface Cloudflare, il faut contrôler les politiques relatives aux robots IA dans les paramètres de sécurité et vérifier séparément les comportements Search, Agent et Training.
Le point qui mérite le plus d’attention concerne Training.
Si cette catégorie est configurée sur Block, il faut déterminer si l’on accepte également les conséquences de cette politique sur les crawlers que Cloudflare considère comme mixtes.
Pour un site dépendant fortement de Google Search, ce choix mérite évidemment quelques minutes de réflexion.
Il faut également vérifier le robots.txt, les éventuelles règles WAF personnalisées et les autres mécanismes de blocage déjà présents.
Accumuler quatre systèmes différents destinés à « bloquer les bots IA » sans savoir lequel fait quoi est généralement une excellente manière de créer un cinquième problème.
Faut-il autoriser ou bloquer les bots IA ?
Il n’existe pas de réponse universelle.
Pour un éditeur dont le modèle économique dépend essentiellement des pages vues et de la publicité, laisser un robot consommer massivement le contenu sans générer de visite peut sembler peu séduisant.
Pour une marque ou un e-commerçant, la situation peut être différente.
Si un assistant IA recommande un produit et génère finalement une vente, le fait que l’utilisateur n’ait pas parcouru cinq pages du site n’est pas nécessairement un problème.
Les agents IA compliquent encore l’équation.
Dans le commerce agentique, bloquer systématiquement la catégorie Agent pourrait un jour revenir à empêcher un assistant d’accéder au catalogue ou aux informations nécessaires pour effectuer un achat pour son utilisateur.
La bonne politique dépend donc du modèle économique.
Mais une règle paraît déjà assez solide :
ne pas bloquer un crawler simplement parce qu’il contient quelque part l’étiquette « IA », sans comprendre ce qu’il fait réellement.
Cloudflare essaie justement de donner davantage de contrôle aux éditeurs.
Encore faut-il regarder les boutons avant de les activer.
Que retenir de cet article ?
- À compter du 15 septembre 2026, Cloudflare modifie ses règles de gestion des crawlers IA et le comportement de ses politiques de blocage.
- Cloudflare distingue désormais trois usages : Search, Training et Agent.
- Les nouveaux domaines Cloudflare bloqueront par défaut Training et Agent sur les pages affichant de la publicité, tandis que Search restera autorisé.
- Le point sensible concerne les crawlers à usages multiples : lorsqu’un robot appartient à plusieurs catégories, la politique la plus restrictive peut s’appliquer.
- Cloudflare cite explicitement Googlebot, Bingbot et Applebot parmi les crawlers susceptibles d’être concernés lorsqu’un site bloque Training.
- robots.txt et le filtrage Cloudflare ne sont pas interchangeables : Cloudflare peut bloquer une requête avant qu’elle n’atteigne normalement le site.
- Pour un site dépendant du référencement naturel, il est donc recommandé de vérifier ses politiques de robots IA à l’occasion du changement du 15 septembre.
- Plus largement, SEO et GEO commencent à partager un nouvel enjeu : décider non seulement comment les machines comprennent le contenu, mais lesquelles ont le droit d’y accéder et pour quel usage.
Sources
Cloudflare — Your site, your rules: new AI traffic options for all customers — 1er juillet 2026
Cloudflare Developers — Block AI Bots
Cloudflare — Control content use for AI training
Cloudflare — Content Independence Day, one year on — juillet 2026